
“AI基础设施正在从单点零组件性能竞争,走向高速互连、供电、散热与整机柜的系统级协同竞争。”立讯技术资深系统架构师李承伟以“系统级协同竞争”概括AI基础设施当前的核心变化。
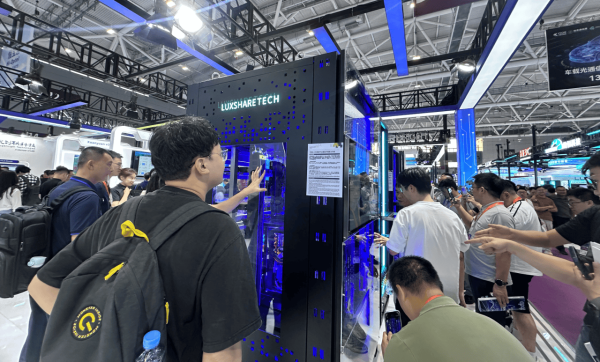
9月9日—11日,第27届中国国际光电博览会(CIOE 2026)在深圳国际会展中心举行。作为智算中心基础环境解决方案商,立讯技术集中展示轩辕系列系统级基础环境方案,以及高速互连、供电管理、热管理等领域的创新成果。
当AI集群继续向Scale-Up和超节点架构演进,高速互连的光铜边界会怎样变化?互连、供电和散热为什么开始进入同一套系统设计?围绕轩辕系列的持续迭代,立讯技术正在AI基础设施产业链中建立怎样的能力边界?
01
高密度算力加速落地,轩辕系列走向系统协同
AI服务器集群持续扩大,机柜内的数据交换规模和功率密度随之上升。IDC数据显示,2026年第一季度全球服务器市场支出同比增长30.7%,GPU服务器保持较快部署节奏。网络侧同样处于升级周期,Dell’Oro Group披露,2026年第二季度AI后端网络交换机销售额首次超过前端网络,800Gbps交换机仍占据绝大多数,1.6Tbps交换机已开始采样,预计下半年加快放量。
计算资源越密集,机柜对供电和热管理的要求就越高。Uptime Institute《2026全球数据中心调查》显示,30kW及以上高密度机架的部署正在增加;Dell’Oro Group今年7月披露,2026年第一季度全球数据中心物理基础设施市场收入同比增长28%,其中热管理市场同比增长接近50%,Busbar等AI数据中心重点配电产品保持较快增长。计算与网络能力持续提升,机柜层需要承接更高功率、更大带宽和更高热流密度,基础环境的重要性随之上升。
从AI基础设施的产业链分工来看,GPU、CPU和交换ASIC构成计算与网络平台的核心芯片基础,高速互连、供电管理和热管理等核心零组件则保障数据、电力与热量在系统内稳定传递,ODM/OEM完成服务器及机柜集成,CSP和数据中心运营商承担规模部署。立讯技术聚焦核心零组件与基础环境层,业务覆盖智算中心、云计算、高性能计算和存储等场景,高速互连方案面向GPU节点、交换机节点及Scale-Up/Scale-Out等架构,热管理与供电产品则覆盖CDU、Manifold、Power Shelf、Busbar等关键部件。较为完整的产品布局,为机柜级联合验证提供了坚实的技术基础。
伴随AI集群向高密度方向发展,轩辕系列的覆盖范围逐步扩大。2025年,立讯技术提出了“三经两纬”框架,以224G/448G高速互连、供电和热管理作为三条技术主线,并覆盖超节点内板级方案与整机柜方案。2026年7月起,轩辕v3的Switch节点和GPU节点方案陆续公开:GPU节点配置6.4T×4/8高速互连模组,一体式冷板单芯片最高散热能力达到2000W,单节点最大供电功率达到10kW;Switch节点配置100T×2 Switch ASIC高速互连模组,一体式冷板单芯片最高散热能力达到2400W,单节点最大供电功率同为10kW,高速线缆模组具备从224G向448G升级的能力。
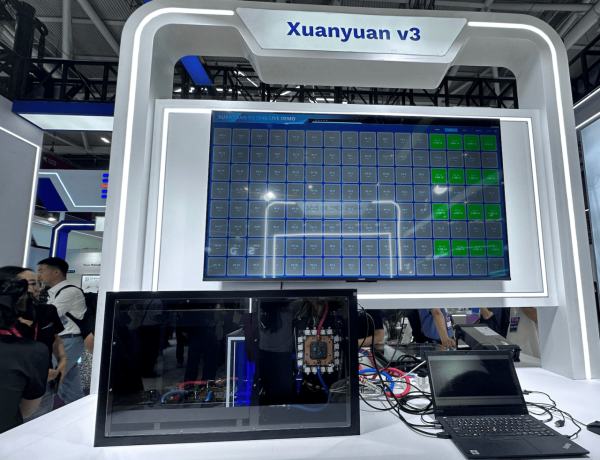
在CIOE 2026展会现场,轩辕v3以正交互连live demo展示高速链路运行状态。李承伟指出,轩辕v2和轩辕v3均围绕单柜多GPU集成场景,实现了高速互连、供电和热管理的联合适配。v3的动态演示将224G高速链路置于多GPU系统环境中运行,链路验证比单个零组件展示更接近真实部署条件。
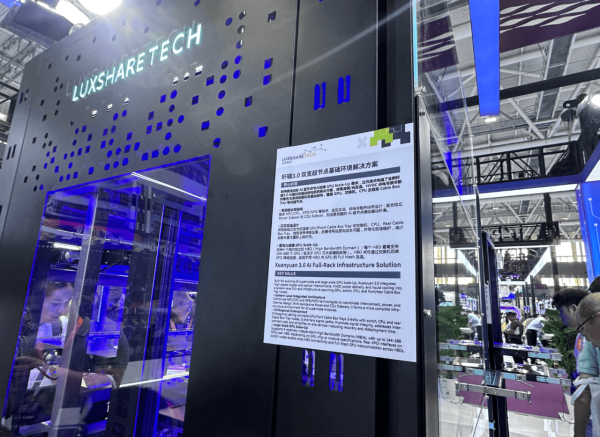
其中,轩辕系列系统级基础环境解决方案,围绕高速铜/光互连、HVDC供电和液冷散热进行系统级协同设计,互连侧融合NPC/CPC、XPO/NPO等技术,并配套独立的Power Sidecar与CDU Sidecar。GPU/Front Cable Box Tray与Switch、CPU、Rear Cable Box Tray之间采用正交连接,以缩短信号传输距离、改善信号质量,并提升现场维护效率。
针对轩辕v3的定位,李承伟强调,该方案更侧重技术架构和系统验证。立讯技术的商业交付仍以零组件和模组级方案为核心,同时向ODM、电源厂商和CSP客户提供系统研究数据作为架构参考。相较于单个零组件开发,轩辕系列增加了前置验证环节,可以更早发现高速互连、供电与热管理之间的工程约束,以此提升零组件与下一代AI平台的适配性。
02
224G迈向448G,光铜边界仍由场景定义
当前高速互连的速率升级,需要区分端口总带宽与单通道电气速率两个维度。800G、1.6T、3.2T通常用于描述端口或光模块的聚合带宽;224G/lane、448G/lane则更多用于描述高速电气互连的单通道信号速率,两类指标不能直接等同。Dell’Oro Group最新数据显示,800Gbps交换机仍占AI后端以太网交换机出货量和销售额的绝大多数,1.6Tbps交换机已经开始采样。从单通道电气互连来看,224G/lane逐步进入部署阶段,下一代448G级互连则继续推进标准与工程验证。
链路速率提高后,铜与光的适用范围仍在动态调整。李承伟认为,随着连接器、线缆、SerDes、材料和封装技术的持续演进,铜互连能够支持的距离和带宽范围会发生变化,光互连在更长距离和更高带宽密度场景中更具优势。工程选型需要综合考虑经济性、可靠性和可维护性。李承伟用一句更直接的话概括:“能用铜的地方一定会用铜。”
以机柜内部和相邻机柜的短距链路为例,李承伟介绍,面向448G互连目标,无源铜缆已经可以覆盖部分连接需求。短距采用铜缆能够省去额外的光电转换,在成本、功耗、可靠性和维护便利性方面具有现实优势。传输距离拉长后,光互连在带宽密度和距离上的价值更加突出,跨多柜及更大规模集群会形成更明确的光连接需求。
另外,立讯技术在本届CIOE同时展示448G CPC超高速互连Live Demo和3.2T NPO光引擎Live Demo。
CPC(Co-Packaged Copper,共封装铜互连)将高速铜连接布置得更靠近ASIC,以缩短高速电气路径;NPO(Near-Packaged Optics,近封装光)将光引擎放置在靠近交换芯片的位置,用于降低高速电链路损耗。NEXUS高速互连组件、OSFP光电组件和5000A液冷Busbar等展品,覆盖高速互连、光电组件与供电等多个环节。
光互连产品的速率和封装形态仍在快速演进。LightCounting在2026年7月发布的研究已将3.2T Ethernet光模块、LPO/LRO及CPO/NPO纳入后续市场预测,并指出NPO开发活动明显升温。李承伟在采访中区分了训练与推理的需求:训练系统更关注通信带宽和数据吞吐,推理基础设施需要在计算平台选择、部署成本、供电与热管理之间取得平衡。不同负载对应不同的基础环境要求,光铜互连因此会在相当长时间内并行发展。
03
系统验证深入架构层,立讯技术拓展零组件能力边界
在AI基础设施产业链中,芯片平台、核心零组件、系统集成和规模部署各有明确分工。Rack-scale GPU系统加速落地后,芯片平台、整机设计和核心零组件之间需要更早开展协同。IDC在2026年服务器市场展望中提到,Rack-scale GPU部署持续推进,ODM定制机柜、OEM Rack-scale系统与标准机柜配置的市场结构正在变化。系统复杂度上升,高速互连、供电管理和热管理厂商参与架构验证的时间随之提前。
立讯技术所处的核心零组件层,连接芯片平台与整机系统。高速互连影响芯片和节点之间的数据交换效率,Power Shelf、Busbar等部件承担高功率供电任务,CDU、Manifold和冷板负责高热流密度器件的热量转移。机柜密度提升后,线缆路径、供电布局和液冷管路之间的空间与性能约束更加明显,零组件厂商对系统架构的理解会直接影响产品验证效率。
轩辕v3以统一平台统筹高速互连、供电和热管理的预研工作。链路接口与走线、供电布局、液冷路径和维护空间可以在同一环境中完成联动验证,相关结果用于连接器、线缆、光电组件、电源和热管理产品的设计优化。李承伟透露,立讯技术已经围绕相关方案与ODM、电源厂商和CSP客户开展交流,系统研究数据能够为客户的平台设计提供参考。
从交付形态看,立讯技术仍以零组件和模组为核心,轩辕系列主要承担前期预研、测试和架构协同。高速互连、热管理与供电管理的跨域融合,使立讯技术能够在客户平台定义阶段识别物理冲突和性能约束,并据此调整零组件设计,提升后续集成与验证效率。
高密度AI机柜逐步进入规模部署后,客户对零组件厂商的评价维度增加了整机架构适配与联合验证。芯片性能决定算力上限,数据链路、供电和热管理能否匹配整机架构,则影响系统能否长期稳定运行。轩辕系列强化了立讯技术在系统级预研与联合验证环节的能力,使零组件研发更早进入下一代AI平台的架构适配过程。
04
结语
AI服务器和后端网络持续升级,高密度机柜随之面临更高的带宽、功率与散热要求。单个零组件仍要突破性能边界,工程落地则越来越依赖各系统之间的匹配。算力能否稳定释放,要看高速信号、电力和热量能否在有限空间内有序流动。
在CIOE 2026现场,立讯技术通过轩辕v3 224G Live Demo展示了新一代高速互连能力,并通过轩辕系列系统级基础环境解决方案,将高速铜/光互连、HVDC供电、液冷散热及多节点架构纳入统一设计。同期展示的3.2T NPO光引擎与448G CPC超高速互连,进一步体现了立讯技术在高速光互连和铜互连两条路线上的技术布局。
李承伟所说的“系统级协同竞争”,精准点出了AI基础设施工程重心的演进逻辑。单柜算力密度、互连速率与功率水平正在不断提升,单个零组件的性能固然是基础,高速互连、供电与热管理之间的协同效率,越来越直接地影响整套系统的稳定运行与规模化部署。
未来两三年,AI基础设施仍会沿着更高带宽、更高功率密度和更高集成度持续演进。随着224G向448G推进,光互连向3.2T及更高速率延伸,液冷与高功率供电加快进入高密度机柜,芯片、互连、供电和散热之间的耦合关系也会更加紧密。产品性能依然是进入市场的基础,系统效率、可靠性、可维护性和规模化部署能力,将会进一步拉开不同AI基础设施方案之间的差距。


